2.2. Comonade exponentielle et fragments
L'exponentielle vient de Girard, qui distingue les fragments cartésien, affine et linéaire comme
restrictions successives de la contraction et de l'affaiblissement, et isole ! comme l'opérateur
les restituant à la demande. Sa traduction de l'implication intuitionniste en !A \multimap B
établit que rien ne se perd à descendre au fragment linéaire — résultat dont la complétude pleine a
depuis été démontrée [2], et sur lequel
repose la sédimentation triadique tout entière. La formalisation catégorique exacte s'est révélée
plus délicate que l'énoncé logique : les premières propositions, identifiant ! à un foncteur muni
des isomorphismes !(A \& B) \cong \, !A \otimes \, !B et ! \top \cong I, laissaient
sous-déterminée la compatibilité entre la comultiplication et le comonoïde induit sur chaque !A —
compatibilité pourtant nécessaire à la cartésianité de la catégorie de co-Kleisli. La correction est
due à Bierman, construisant sur Seely : sa définition de catégorie linéaire, imposant que chaque
\delta_A soit un morphisme de comonoïdes, s'est imposée, et c'est elle que cette section
instancie. Schalk en donne l'exposé avec les preuves et recense les formulations équivalentes [3], [4].
La lignée s'est prolongée dans une direction que K7PL suit : l'exponentielle n'est pas condamnée à être un opérateur unique. On peut l'indexer par un semi-anneau : la contraction fusionne alors deux usages par l'addition, et l'application met le contexte de l'argument à l'échelle par la multiplication [5]. La modalité obtenue porte une étiquette qui renseigne sur l'usage du contexte [6]. Sa sémantique catégorique complète est celle d'une comonade exponentielle linéaire indexée, sur une structure de gradation plus riche qu'un semi-anneau ordinaire [7]. Aujourd'hui, la notion de modèle est établie autour d'un objet unique, l'adjonction linéaire-non-linéaire, dont il est acquis qu'elle englobe les notions antérieures — catégories de Seely, catégories de Lafont, catégories linéaires [8]. C'est d'elle que part la construction qui suit, l'exponentielle en étant dérivée plutôt que posée.
Soit F \dashv G une adjonction monoïdale symétrique entre le fragment cartésien et le fragment
linéaire de C, au sens du §2.4. Deux propriétés du
semi-anneau doivent être exigées avant d'aller plus loin, car le lemme de substitution en dépend et
elles ne se déduisent pas des axiomes. La propriété du zéro-somme : si q_1 + q_2 = 0 alors
q_1 = q_2 = 0. Et la propriété du zéro-produit : si q_1 \cdot q_2 = 0 alors q_1 = 0 ou
q_2 = 0. Elles sont ce qui rend les substitutions bien typées [9], et \mathcal{R}
les satisfait — un produit de rationnels positifs n'est nul que si un facteur l'est, et \omega
absorbe sans annuler. Les satisfaire et les exiger sont deux choses, et c'est la seconde qui compte
pour une mécanisation.
Une clause sur la composante de budget, qui exige davantage que le semi-anneau ne donne. Elle
emploie la soustraction tronquée \ominus, qui n'est ni l'addition ni le produit et ne s'en dérive
pas. Sa définition demande d'être écrite par cas, et le choix entre deux candidates n'est pas
indifférent :
\beta \ominus k \;=\; \begin{cases} \omega & \text{si } \beta = \omega\\ 0 & \text{si } \beta < k\\ \beta - k & \text{sinon} \end{cases}
C'est la soustraction tronquée prolongée en \omega, et il faut dire ce qu'elle n'est pas : ce
n'est pas le résidu de l'addition. Le résidu — le plus petit x tel que k + x \ge \beta —
rendrait \omega \ominus \omega = 0, puisque \omega + 0 \ge \omega. RMQ 14. Deux définitions qui
coïncident sur les entiers et divergent à l'infini. Celle qu'on retient est celle qui ne promet rien
qu'elle ne tienne. La différence n'est visible qu'en \omega, et elle décide de la vérité d'une
loi que six démonstrations invoquent : l'annotation se lit comme une borne et non comme une
mesure, et pour une borne \omega \ominus \omega = \omega est la sur-approximation sûre, quand le
résidu annoncerait un budget nul là où rien ne le garantit.
La structure requise pour cette composante est donc un monoïde commutatif naturellement ordonné muni de cette soustraction, dont la part semi-anneau n'est qu'un fragment. Les conaturels la satisfont — d'où le fait que la question ne se pose jamais en pratique —, mais la satisfaire et l'impliquer sont deux choses, et on exige ici ce qu'on emploie. Une structure concurrente est écartée explicitement, étant celle qu'on propose spontanément pour un budget : le semi-anneau tropical, où le minimum tient lieu de somme. On y gagnerait le pire cas comme opération primitive~; on y perdrait la finitude de l'axiomatisation, aucun des semi-anneaux exotiques usuellement considérés n'ayant de base finie pour ses équations, non plus que les semi-anneaux faibles commutatifs idempotents qui les sous-tendent [10]. Pour un document dont les règles doivent se vérifier par machine, une axiomatisation infinie n'est pas un inconvénient de présentation~: c'est un obstacle. Le choix des conaturels résidués se paie donc d'une opération de moins et s'achète une théorie équationnelle finie.
Soit par ailleurs
\mathcal{R} = (\mathbb{Q}_{\ge 0} \cup \{\omega\},\,+,\, \times,\, 0,\, 1,\, \le) le semi-anneau
ordonné des grades : le porteur contient les rationnels positifs — les capacités de lecture divisées
du chapitre 3 en ont besoin — et un élément absorbant \omega pour l'usage non contraint. Ce
dernier n'est pas une commodité ajoutée : restreint au sous-semi-anneau des entiers,
\mathcal{R} est le type des conaturels \mathbb{N}_\infty, dual coinductif des naturels, dont
il est établi qu'ils forment un semi-anneau commutatif exponentiel [11].
Quatre égalités gouvernent \omega et se lisent partout sans être écrites nulle part ; les voici,
car trois démonstrations en dépendent :
0 \cdot \omega = 0 \qquad \omega \cdot 0 = 0 \qquad \omega + \omega = \omega \qquad \omega \cdot \omega = \omega
\omega absorbe donc l'addition et le produit, sauf devant 0 qui l'absorbe en retour — c'est la
convention ordinaire du sous-semi-anneau des entiers étendu, et la seule qui fasse de 0 un grade
signifiant « jamais employé ».
La restriction est à prendre au mot et la suite s'en sert. \mathbb{N}_\infty \subset \mathcal{R}
est le seul fragment du porteur dont l'ordre strict soit bien fondé : sur les rationnels il ne l'est
pas, la chaîne 1 > 1/2 > 1/4 > \dots ne terminant jamais. Un grade et un indice de taille vivent
donc dans la même algèbre sans y avoir les mêmes droits, et
§2.3 pose la clause qui les sépare.
Une conséquence borne ce que cette structure peut fournir ailleurs. \mathcal{R} est naturellement
ordonné, ce qui suffit à en faire un support d'évaluation pour un moteur déductif, dont la
complexité en données s'analyse en deux temps — mise à plat du programme en un système d'équations
polynomiales, puis plus petit point fixe sur le semi-anneau [12].
Mais les deux classes pour lesquelles cette évaluation admet des algorithmes efficaces —
semi-anneaux de rang fini, semi-anneaux absorbants totalement ordonnés — ne contiennent pas
\mathcal{R} : les conaturels ne sont ni de rang fini, ni absorbants au sens où a + a\,b = a.
Une extension déductive n'hériterait donc pas sa borne de coût du semi-anneau des grades. Elle
évaluerait sur un semi-anneau propre — le booléen pour les règles ordinaires, qui est de rang fini
et absorbant —, structure supplémentaire et non réemploi.
Une loi se démontre ici plutôt qu'aux règles de typage (§3.6), et le choix du lieu est l'objet du théorème. Elle
relie les deux actions que le grade exerce — \varphi_r sur l'effet, \psi sur le contexte —,
elle ne demande que l'arithmétique de \mathcal{R} qui précède, et le reste du document l'emploie
quatre fois sans jamais la redémontrer.
Pour tous u, \beta, k \in \mathbb{N}_\infty tels que u \neq \omega ou k = 0,
u \cdot (\beta \ominus k) \;=\; (u \cdot \beta) \ominus (u \cdot k). La restriction est
nécessaire : pour u = \omega et k \neq 0, l'égalité est fausse quelle que soit la valeur
donnée à \omega \ominus \omega.
Trois cas pour l'énoncé. Si u = 0, les deux membres valent 0. Si u est fini et \beta,
k finis, c'est la distributivité ordinaire sur la soustraction tronquée des naturels ; si
\beta = \omega, les deux membres valent \omega pour u \neq 0. Si k = 0, la soustraction
est l'identité des deux côtés.
Et la nécessité de la restriction, qui est ce que l'énoncé apporte. Prenons u = \omega et
\beta, k finis avec k \neq 0. Pour \beta = k, le membre gauche vaut \omega \cdot 0 = 0
et le droit \omega \ominus \omega ; l'égalité demande \omega \ominus \omega = 0. Pour
\beta = 5 et k = 3, le membre gauche vaut \omega \cdot 2 = \omega et le droit
\omega \ominus \omega ; l'égalité demande \omega \ominus \omega = \omega. Une même expression
ne peut pas valoir les deux. Aucune définition de \ominus ne rend donc la loi vraie en
u = \omega, et ce n'est pas une affaire de convention à choisir mais une restriction à porter.
Ce lemme sert trois fois — à la loi qui suit, à la généralisation de l'addition par la composition de contextes, et au lemme de substitution. Il est écrit une fois, et chacun des trois le cite.
Pour tout contexte \Delta, tout effet \varepsilon et tout grade r dont la composante
d'usage u est finie — ou dont l'effet traversé est sans coût temporel, k(\varepsilon) = 0 —,
r \cdot \psi(\Delta, \varepsilon) \;=\; \psi\bigl(r \cdot \Delta,\ \varphi_r(\varepsilon)\bigr).
Toutes les composantes du grade coïncident sans rien demander sauf une, \psi y étant l'identité.
Reste le budget : le membre gauche vaut u\,(\beta \ominus k) et le droit u\beta \ominus u\,k,
puisque \varphi_r porte la composante temporelle à u\,k. C'est exactement le
théorème 1, dont la loi hérite la restriction : elle ne vaut pas
pour un usage infini traversant un effet à coût non nul.
Quatre démonstrations la réclament ensuite, et aucune n'a de raison de la redécouvrir : le lemme de substitution, la relation logique, la traduction vers le métalangage et l'expansion des macros. Chacune dira « par le théorème 2 », et rien de plus.
Une seconde composition est apparue depuis que les effets se mettent en parallèle, et la loi doit valoir pour elle aussi — faute de quoi elle ne vaudrait que du fragment séquentiel, c'est-à-dire de la moitié du langage.
Sous la même restriction que le théorème précédent, et pour tous effets
\varepsilon_1, \varepsilon_2,
\varphi_r(\varepsilon_1 \parallel \varepsilon_2) \;=\; \varphi_r(\varepsilon_1) \parallel \varphi_r(\varepsilon_2).
Sur la composante de travail, c'est la distributivité du produit sur l'addition. Sur la composante
de profondeur, c'est u \cdot \max(s_1, s_2) = \max(u s_1, u s_2), vraie dans \mathbb{N}_\infty
pour tout u, \omega compris : la multiplication y est croissante, et une fonction croissante
commute au maximum.
Une conséquence porte sur le budget, et elle n'est pas de forme. Le postulat P3 bornant désormais
les deux composantes du temps, le budget qu'une liaison porte en est un couple lui aussi, et
\psi le décroît composante par composante. Employer r fois un calcul multiplie donc son
travail et sa profondeur par r, ce qui est la lecture attendue : réexécuter un calcul parallèle
ne le rend pas plus parallèle. RMQ 15. Réexécuter dix fois un calcul de profondeur trois donne une
profondeur trente, non trois. Le parallélisme est interne à une exécution, il ne se répète pas entre
elles.
La restriction que ce théorème porte n'est pas une précaution de rédaction : elle a une contrepartie dans les règles. Les deux règles qui composent un calcul avec un calcul — l'application et la liaison séquentielle — portent une condition de bord que les règles de typage écrivent : un argument de grade infini ne peut traverser un effet à coût temporel non nul. La condition est d'ailleurs ce que la sédimentation prédisait sans le dire : un usage non contraint appartient au fragment cartésien, lequel est pur et n'a donc pas d'effet à traverser. RMQ 16. Une restriction qu'on croyait coûteuse et qui ne mord que sur des programmes que la stratification écartait déjà. Ce qu'elle rejette est un calcul qui prétendrait employer une ressource un nombre non borné de fois en payant un temps à chaque fois, et le budget ne saurait pas le tarifer.
L'infini de \mathcal{R} dénote ce que la couche 2 a besoin de dénoter — le décompte d'étapes d'un
calcul qui peut ne pas s'arrêter —, et le caractère exponentiel du semi-anneau fournit la structure
des grades sous abstraction fonctionnelle, que le chapitre 3 (§3.1)
obtient aujourd'hui de la seule multiplication. La structure exponentielle est alors une famille
\{\,!_r\,\}_{r \in \mathcal{R}} d'endofoncteurs sur C, munie de :
-
une déréliction
\varepsilon : \, !_1 \Rightarrow \text{Id}, qui n'existe qu'au grade1— consommer une ressource exactement une fois, c'est l'obtenir ; -
une comultiplication
\delta_{r,s} : \, !_{r \times s} \Rightarrow \, !_r !_s, qui indexe l'itération de l'exponentielle par le produit du semi-anneau ; -
un affaiblissement
w : \, !_0 \Rightarrow I, disponible au seul grade0; -
une contraction
c_{r,s} : \, !_{r+s} \Rightarrow \, !_r \otimes \, !_s, qui répartit un grade par la somme.
Ces quatre transformations satisfont les lois de coassociativité, de coünité et de comonoïde de la
présentation classique, indexées par \mathcal{R} ; l'ordre \le y induit des morphismes de
sous-gradation !_r \Rightarrow \, !_s pour s \le r. Cette structure est celle que la
littérature nomme comonade exponentielle linéaire indexée [7].
Ce que le paragraphe précédent décrit n'est donc pas une structure primitive mais le résultat d'une composition, et l'ordre dans lequel ce chapitre l'expose reflète l'ordre dans lequel la littérature l'a établie. Benton a montré que l'exponentielle de la logique linéaire se scinde en deux modalités adjointes reliant une logique intuitionniste à une logique linéaire. Fujii, Katsumata et Melliès ont établi que toute monade graduée se factorise comme une action stricte transportée le long d'un foncteur adjoint à gauche, et de deux manières — l'une généralisant Eilenberg-Moore, l'autre Kleisli [13]. K7PL en emploie le dual, pour une comonade graduée, et retient la factorisation généralisant Kleisli, puisque c'est la structure de Kleisli graduée que la suite de ce chapitre construit. La conjonction des deux résultats donne, pour les modalités graduées, une paire de modalités adjointes reliant une logique graduée à une logique linéaire graduée [14].
De cette dérivation suit ce dont le chapitre 3 aura besoin, et qui ne se lisait pas sur la comonade seule.
Cette décomposition n'est pas une curiosité de présentation : c'est elle qui donne au chapitre 3 le
lieu où loger le partage. Une catégorie monoïdale symétrique dénote par \otimes la séparation —
deux objets joints par le tenseur sont deux ressources indépendantes —, et scinder un grade par la
contraction produit encore deux objets séparés, non deux vues d'une même ressource. Le partage exige
une diagonale, donc le fragment cartésien ; c'est du côté cartésien de l'adjonction qu'il vit, et
non d'une division opérée du côté linéaire. Le point vaut d'être souligné parce que la littérature
le documente en creux : faire cohabiter dans un même niveau un produit qui sépare et un produit qui
partage brise la correction, et la parade connue est la stratification à deux niveaux [15].
Intuitivement, !_r A dénote une ressource A dont l'usage est autorisé à hauteur de r.
Deux précisions négatives, qui évitent au lecteur de situer C ailleurs qu'elle n'est. K7PL ne
suppose pas son exponentielle libre : la structure de comonoïde gradué y est donnée, non
construite comme comonoïde cocommutatif cofibre sur A, de sorte que C n'est pas une catégorie
de Lafont. Et K7PL ne suppose pas de biproduits finis. Ces deux abstentions vont ensemble, et il
faut dire dans quel sens : c'est la liberté de l'exponentielle qui porte le risque, l'additivité
n'y suffisant pas. Une exponentielle libre jointe aux biproduits finis donne la structure de
catégorie différentielle, donc une codéréliction [16], [17].
La réciproque est fausse, et récemment établie comme telle : une codéréliction induit
l'enrichissement additif, par convolution bialgébrique, de sorte que l'implication ne remonte pas —
une catégorie additive n'a pas pour autant de codéréliction. Il est en outre établi qu'une
codéréliction, lorsqu'elle existe, est unique, ce qui rend la vérification décidable en principe
plutôt qu'affaire d'appréciation.
L'abstention de K7PL est donc plus robuste que sa formulation ne le laissait croire, et c'est la première qui la porte : l'exponentielle étant donnée et non construite comme cofibre, aucun des deux résultats ne s'applique. RMQ 17. Ce qui protège n'est pas de refuser l'addition, c'est de refuser la liberté de l'exponentielle. La nuance décide de quels modèles restent admissibles. Le langage n'a aucun usage de la structure différentielle, et n'a pas à en hériter par inadvertance ; mais un modèle concret peut légitimement en porter davantage que le langage n'en déclare, et c'est le cas ordinaire plutôt que l'exception.
Le gain n'est pas seulement d'expressivité, il est d'économie : les trois fragments cessent d'être trois constructions parallèles pour devenir trois lectures d'un même objet, et les opérations dont le chapitre 3 se sert — diviser un grade, sommer des grades concurrents, mettre un contexte à l'échelle — reçoivent ici leur définition au lieu d'être supposées.
L'indexation par \mathcal{R} n'est pas un ornement ajouté à une structure qui tiendrait sans elle :
c'est ce qui rend w et c opérants. Dans la présentation non graduée, chaque !A porte une
structure de comonoïde commutatif vis-à-vis de \otimes, l'affaiblissement et la contraction y
étant disponibles ou non — un choix binaire, qui ne permet que trois configurations. Ici, le
comonoïde est gradué : w ne s'applique qu'à !_0, et c ne décompose !_{r+s} qu'en
respectant l'addition. L'axiomatisation de la compatibilité entre ce comonoïde et le couple
(\varepsilon, \delta) reste celle que la lignée rappelée ci-dessus a établie, indexée ; K7PL
l'adopte sans réserve dans sa version corrigée et graduée.
Une précision est nécessaire avant de construire, car l'incise « \otimes restreint aux objets
exponentiés » que l'on trouve souvent recouvre une difficulté réelle. Il n'existe en général pas de
structure monoïdale sur la catégorie des coalgèbres libres — isomorphe à la catégorie de co-Kleisli
—, le tenseur ne s'y faisant pas bifoncteur faute de définition sensée sur les morphismes. La
structure de produit ne s'obtient qu'en plongeant cette catégorie dans une catégorie plus large, où
le produit tensoriel de deux objets a !A \otimes !B pour objet sous-jacent [3].
C'est ce détour, et non une restriction, que la construction qui suit emprunte.
Chaque grade ne définit pas sa catégorie, et l'écrire ainsi serait faux. Ce que la comonade graduée
engendre est une structure de Kleisli graduée \mathbf{Kl}_{\mathcal{R}} : sur les objets de
C, la famille des ensembles de morphismes
\text{Hom}^r(A,B) := \text{Hom}_{\mathcal{C}}(\,!_r A, B), indexée par le semi-anneau des grades.
Elle porte une composition
\text{Hom}^r(A,B) \times \text{Hom}^s(B,C) \to \text{Hom}^{r \times s}(A,C), donnée par
g \circ \, !_s f \circ \delta_{s,r} : le grade se multiplie le long de la composition. Mais cette
composition n'est pas interne à un grade, et l'identité n'existe qu'au grade neutre, où elle est
\varepsilon_A. Une catégorie demande l'une et l'autre ; la famille graduée n'en est donc pas une
à chaque grade. La multiplication du grade le long de la composition est la lecture catégorique de
la mise à l'échelle du contexte dont le chapitre 3 (§3.1) fera un
usage constant.
Deux grades font exception, et ce sont les seuls qui portent une catégorie. Au grade neutre
r = 1, la composition est interne et l'identité existe : \text{Hom}^1 est la catégorie de
co-Kleisli de la comonade !_1. Au grade absorbant \omega, le comonoïde gradué munit
\mathcal{C}_{!_\omega} d'un objet terminal (I, via w, disponible puisque 0 \le \omega)
et de produits binaires (\otimes restreint aux objets exponentiés, via c_{\omega,\omega}, la
somme y étant absorbante). La formalisation corrigée rappelée ci-dessus établit précisément que
cette structure satisfait les lois d'une catégorie cartésienne.
Deux statuts se distinguent ici, et les confondre serait se dénigrer. Que les foncteurs d'inclusion entre fragments soient fidèles est immédiat, vérifiable sur la construction. Que la catégorie de co-Kleisli du grade absorbant soit authentiquement cartésienne n'est pas assumé non plus : cela suit de la définition de catégorie linéaire retenue ci-dessus, dont la preuve est publiée et dont des formulations équivalentes sont établies [3], [4].
Ce que ce document assume est le théorème de cohérence proprement dit — celui qui garantit que les diagrammes construits à partir des isomorphismes naturels commutent —, et il l'assume comme le fait la littérature primaire dont il reprend les constructions, qui le référence sans le redémontrer [18], [19]. Deux précisions s'imposent sur cet emprunt, car il porte sur deux choses d'espèce différente que le mot « assumer » recouvrirait sans les distinguer.
La première est que la cohérence emprunte à deux régimes. Pour la part monoïdale, c'est bien un théorème publié. La catégorie close de Kelly et Mac Lane est une catégorie munie du tenseur et de l'exponentiation interne, d'une unité, des isomorphismes d'associativité et de symétrie et de six diagrammes d'axiomes — structure que leurs auteurs disent non essentiellement différente d'une monoïdale symétrique close. Leur théorème garantit la commutation de tout diagramme bâti sur ces isomorphismes. Pour la part graduée, en revanche, il n'y a pas de théorème à assumer : les lois de la comonade graduée — counité, coassociativité indexée par le produit du semi-anneau — sont posées comme axiomes de la structure. Un théorème de cohérence sert là où les isomorphismes ne sont pas donnés commutants et doivent être prouvés tels ; ici ils le sont par définition. Assumer un théorème et poser un axiome ne sont pas le même acte, et le lecteur a le droit de savoir lequel porte quoi.
La seconde est que la chaîne d'hypothèses de l'adjonction, telle que la littérature l'exhibe, compte
trois maillons et non deux. Une comonade monoïdale sur une monoïdale symétrique donne une
structure monoïdale aux coalgèbres. La clôture de la base rend les coalgèbres libres exponentiables.
Et c'est seulement si de plus la catégorie des coalgèbres libres est close par le tenseur qu'elle
est elle-même monoïdale symétrique close. Ce document pose le premier maillon par P1, dérive le
deuxième de l'adjonction monoïdale — une composée de foncteurs monoïdaux étant monoïdale —, et
acquitte le troisième par le choix de la définition de catégorie linéaire, qui l'inclut. C'est ce
troisième maillon que ce choix paie, et non un emprunt tacite. Le cas gradué s'y transpose sans rien
demander de neuf : la clause « toute puissance d'une coalgèbre libre est libre » y devient la
relation entre !_r A \otimes !_s A et !_{r+s} A, c'est-à-dire le comonoïde gradué posé
ci-dessus. La frontière passe là : l'agencement des briques est propre à K7PL, la sémantique de la
logique linéaire ne l'est pas.
\mathcal{C}_{!_\omega} est donc cartésienne : c'est le fragment cartésien de la sédimentation
triadique, et la partie \Delta_{\omega} du contexte germinal n'est que la notation, hors de
\mathcal{C}_{!_\omega}, pour un objet vu à travers cette catégorie. C'est ce que le chapitre 1
(§1.4) annonçait en écartant la zone \Gamma de la présentation
usuelle. La construction qui précède en est la justification, et c'est sur les grades — non sur une
disposition de zones — que l'adjonction dont ce paragraphe établit le côté cartésien se lit.
Les trois fragments de la sédimentation triadique ne se construisent alors plus séparément : ce sont
les images de trois sous-ensembles distingués du porteur de \mathcal{R}.
-
Le fragment linéaire strict est l'image de
\{1\}:\varepsilony est disponible, niwnicn'y sont instanciables, faute des grades0etr+s. -
Le fragment affine est l'image de
\{0,1\}:wy devient disponible au grade0, mais aucune contraction ne s'y instancie, la somme sortant de l'ensemble. C'est une convention parmi d'autres — certains traitements de la logique affine préfèrent une exponentielle propre, dont on établirait séparément comonade et comonoïde. Les deux coïncident sur ce qui importe ici, un objet muni de l'affaiblissement et non de la contraction, sans s'équiper des mêmes propriétés plus fines. -
Le fragment cartésien est l'image de
\{\omega\}, sous-ensemble clos par+et\timeset absorbant : contraction et affaiblissement y sont l'un et l'autre disponibles, et\mathcal{C}_{!_\omega}est cartésienne au sens du paragraphe précédent.
Ce que les délimiteurs syntaxiques du chapitre 5 annoncent n'est donc rien d'autre que le
sous-ensemble de \mathcal{R} dans lequel l'expression ouverte est autorisée à puiser ses grades.
Et les grades intermédiaires — 1/N pour les capacités de lecture divisées, k pour l'âge d'une
destination — ne sont pas des exceptions à cette structure : ce sont ses habitants ordinaires, que
les trois sous-ensembles distingués ne suffisaient simplement pas à nommer.
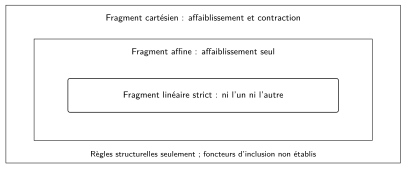
Emboîtement des trois fragments logiques par restriction successive des règles structurelles
Les trois fragments comme trois restrictions successives d'une même construction, et non comme trois systèmes bâtis séparément.
Notons \mathcal{C}_{!_S} la sous-catégorie large obtenue en n'autorisant que les grades du
sous-ensemble S \subseteq \mathcal{R}. Les singletons \{1\}, \{0,1\} et \{\omega\} sont ici les fragments logiques ; les modalités de type du chapitre 3 sont les intervalles de \mathcal{R}, dont ils sont des cas particuliers, et c'est la notation par intervalles qui fait foi pour les types. Ces trois catégories s'emboîtent, et l'emboîtement n'est
plus à démontrer : il se lit sur l'inclusion des sous-ensembles. Tout morphisme de
\mathcal{C}_{!_{\{1\}}}, n'invoquant ni affaiblissement ni contraction, reste a fortiori légitime
dans \mathcal{C}_{!_{\{0,1\}}} dès que le grade 0 devient disponible sans devenir obligatoire.
De même, tout morphisme de \mathcal{C}_{!_{\{0,1\}}} reste légitime dans
\mathcal{C}_{!_\omega} dès que la somme cesse de sortir de l'ensemble. Il existe ainsi des
foncteurs d'inclusion
\begin{equation*}\tag{6}
F_{1 \to 2} : \text{Linéaire} \hookrightarrow \text{Affine} \qquad F_{2 \to 3} : \text{Affine} \hookrightarrow \text{Cartésien}
\end{equation*}
fidèles : aucune identification n'est introduite en passant d'un fragment à l'autre, un morphisme du
fragment le plus contraint désignant, dans le fragment moins contraint, exactement le même morphisme
de C. Ils ne sont pas pleins : franchir l'inclusion, c'est gagner l'accès à de nouveaux morphismes
construits à partir de w ou de c, ce qui est tout le sens de relâcher une règle structurelle.
La fidélité seule suffit pourtant à garantir ce que le chapitre 1 attendait de cette construction —
un terme déjà établi dans le fragment le plus contraint conserve, relu dans un fragment moins
contraint, la même dénotation. C'est cette conservativité, non une préservation de la totalité des
morphismes disponibles, qui justifie qu'imbriquer un fragment de programme dans un contexte moins
contraint n'altère jamais sa sémantique.
Cette stratification catégorique est le pendant de l'ordre de précision
\text{Unr} \sqsubseteq \text{Aff} \sqsubseteq \text{Lin} énoncé au chapitre 1. Une ressource dont l'usage est
prouvé dans le fragment le plus contraint demeure, sans aucune reformulation, une ressource valide
dans tout fragment moins contraint. C'est la même inclusion, lue une fois sur les catégories de
preuves, une fois sur les types qu'elles habitent. L'inclusion des sous-ensembles
\{1\} \subset \{0,1\} \subset \{\omega\}^\downarrow dans \mathcal{R} en est désormais la
source unique, ce qui referme la construction de P1. La structure exponentielle annoncée au chapitre
1 est celle-ci ; et la cinquième composante \mathcal{G} du jugement germinal y trouve son
interprétation — elle dénote l'indice de la famille.