4.2. Échelle locale
À l'échelle la plus fine, un automate n'est pas une métaphore : c'est la forme même que prend l'exécution, que celle-ci reconnaisse un motif ou calcule un pli. Cette section décrit les deux automates de couche 3 — l'un pour le filtrage, l'autre pour le calcul —, puis les deux régimes d'exécution, fibrilles et fibres, qui les portent.
Les R-expressions unifient sous une seule interface, (match ...), le filtrage structurel, PCRE,
PEG et les grammaires ; leur compilation ne masque jamais la complexité qu'un motif engage, elle
l'expose. Chaque constructeur porte une annotation : @linear pour un automate fini déterministe
(linéaire en la longueur du texte, constant par octet ou par bloc), @polynomial pour un automate
non déterministe, @stack pour un automate à pile (analyse polynomiale, pile proportionnelle à la
profondeur d'imbrication) et @backtrack pour le retour arrière explicite, seul exponentiel — le
coût exponentiel vient du retour arrière, non de la pile. Trois conséquences en découlent.
-
Un motif utilisant une classe de caractères, une répétition ou une composition simple se résout en un DFA minimal, abaissé en instructions de masquage vectoriel qui avancent par blocs de 16, 32 ou 64 octets.
-
Une assertion, une référence arrière ou une récursion exige un NFA ou un PDA explicite plutôt qu'un DFA.
-
Le vérificateur de complexité (chapitre 6) rejette toute structure non linéaire apparaissant dans un contexte annoté
@linear.
Ce dernier rejet n'est pas une détection heuristique de motifs pathologiques : c'est une preuve
d'admissibilité, qui prévient structurellement le déni de service par expression régulière. Pour les
motifs non linéaires, la profondeur maximale de la pile du PDA est elle-même un grade r que le
solveur SMT vérifie compatible avec la mémoire disponible. La discipline retenue est celle de la pile bornée : la profondeur n'est un grade statique que pour une entrée de longueur bornée à la compilation ou pour un analyseur à pile bornée, et dans ce second cas la classe reconnue rétrécit à celle des motifs dont l'imbrication ne dépasse pas r. Cela garantit à cet automate, comme à tout
autre composant de K7PL, une borne statique. Les positions capturées ne sont jamais copiées : ce
sont des paires d'offsets dans le texte source lui-même.
Les trois analyses d'automates que ce document conduit — les R-expressions ici, le protocole Noise comme automate fini au §4.5, la syntaxe de K7PL au §5.1 — se rangent dans une même table, et P3 s'y applique une fois : le temps et l'espace sont donnés par la machine, non par l'affirmation locale.
Classes de motifs et bornes : machine, temps, espace, classe reconnue
Analyse | Machine | Temps | Espace | Classe reconnue |
|---|---|---|---|---|
R-expression | automate fini déterministe |
|
| langages réguliers |
R-expression | automate à pile |
polynomial en | proportionnel à la profondeur d'imbrication, bornée par un grade | langages hors contexte, à pile bornée |
R-expression | retour arrière explicite | exponentiel | proportionnel à la profondeur de retour | motifs avec références arrière |
Protocole Noise | automate fini déterministe |
|
| séquences de messages d'un protocole fixé |
Syntaxe de K7PL | grammaire à pile visible |
|
| trois paires de délimiteurs, un seul sens d'imbrication |
Cette hiérarchie est celle des machines, et n'est qu'une coupe d'un espace à deux dimensions. La seconde dimension est précisément celle où ce chapitre se déplacera s'il tient sa promesse. Le compte rendu coalgébrique de la théorie des automates ne gradue pas seulement du déterministe au non déterministe. Il ajoute l'alternant, et surtout il indexe toute la construction par le choix du foncteur, lequel décide sur quoi l'automate opère — des mots, des arbres, des arbres à branchement non borné, des systèmes de transitions étiquetés. Sous une hypothèse unique, que ce foncteur préserve les produits fibrés faibles, la classe des langages reconnaissables reste close par réunion, intersection et projection, et tout automate alternant se transforme en un non déterministe équivalent dont la taille est bornée exponentiellement [5].
Une seconde coupe du même objet fait du passage du déterministe au non déterministe un changement de base bicatégorique, et de l'accessibilité une extension de Kan [6–7]. Ce que ce document gagne à le dire n'est pas décoratif : les annotations ci-dessus fixent la première dimension et laissent la seconde implicite, en supposant partout que le foncteur est celui des mots. C'est vrai des R-expressions sur du texte ; ce ne l'est plus d'une R-expression qui filtrerait des arbres de syntaxe, cas que la réserve du paragraphe suivant vise par un autre chemin.
Deux acquis de cette même littérature portent sur des constructions que ce chapitre emploie sans les avoir situées. Le premier concerne la minimalisation d'un automate gradué, qui n'était pas définie ici. La réalisation de Nerode existe et est unique à isomorphisme près pour les langages de multiensembles ; or un multiensemble est un compte d'occurrences, c'est-à-dire exactement la composante d'usage du grade. Minimaliser un automate gradué, c'est donc construire la réalisation minimale de son comportement, ce qui donne ce que ce document n'avait pas : un critère d'identité entre deux automates construits différemment [8]. La version générale s'obtient sous des hypothèses modestes, les effets de bord restant en paramètre, avec sa procédure de déterminisation [9]. Le second prolonge l'argument d'unité posé en ouverture de ce chapitre : l'inférence d'un automate depuis des observations est le pendant, côté comportement, de ce que la synthèse dirigée par les grades fait côté type.
Deux des techniques réunies sous cette interface appellent une précision de ce que l'on échange, faute de quoi le chapitre vendrait des propriétés qu'il n'a pas. La première porte sur les grammaires d'expressions d'analyse, dont l'absence d'ambiguïté est un argument affiché. Ce qui est cédé en retour est nommé par leur auteur même : à la place de déterminer si deux alternatives d'une grammaire hors contexte sont ambiguës, le concepteur doit déterminer si deux alternatives d'un choix priorisé peuvent être réordonnées sans changer le langage — question indécidable en général [10]. L'ambiguïté n'est donc pas éliminée, elle est déplacée du texte analysé vers la grammaire qui l'analyse, et le déplacement vaut d'être dit.
La seconde porte sur l'annotation de coût de l'analyse à mémoïsation, qui nomme le temps et tait l'espace. Son auteur relève lui-même l'inconvénient principal : l'espace y est proportionnel à la taille de l'entrée et non à la profondeur maximale de récursion, deux grandeurs qui peuvent différer de plusieurs ordres de grandeur, et sa défense est comparative plutôt qu'absolue [11]. Or P3 interdit de dissimuler un coût, et un coût annoncé sur une seule dimension en dissimule une autre. Le point n'est pas seulement de méthode : l'analyse par dérivée d'une grammaire à pile visible — celle dont §5.1 montre que la syntaxe de K7PL relève par construction — donne le même temps linéaire avec une pile, donc un espace proportionnel à la profondeur d'imbrication [12]. Sur le postulat qui gouverne ce projet, la seconde technique domine la première. Les deux coûts sont donc annoncés ici, et le choix de technique est laissé à l'implantation plutôt que réputé neutre.
L'annotation @polynomial repose sur une hypothèse qui doit être nommée : que la déterminisation
d'un automate non déterministe existe. Elle est acquise dans le cadre ensembliste ordinaire, et
elle ne l'est pas partout. Dans le cadre nominal — celui où les états portent des noms modulo
permutation —, la construction de l'ensemble des parties finies ne préserve pas la finitude par
orbites, et la déterminisation standard échoue [13]. La
question n'est pas oiseuse pour ce document, qui manipule des noms modulo \alpha-équivalence au
chapitre 5. Deux réponses sont possibles et une seule est écrite ici : les automates de cette
section opèrent sur des caractères et non sur des noms, de sorte qu'ils restent dans le cadre
ensembliste et que l'annotation tient. Si un motif venait un jour à filtrer sur des noms liés — une
R-expression sur des AST plutôt que sur du texte —, l'annotation devrait être revue, et ce qui
survivrait sans condition est la minimalisation des automates déterministes, qui ne dépend pas de
la symétrie des données.
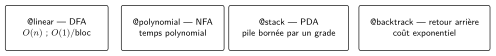
Hiérarchie de complexité des R-expressions
Les trois classes de complexité qu'une R-expression peut atteindre, et l'automate qui répond à chacune.
Le pli sur une algèbre initiale (chapitre 2, §2.3) admet
la même lecture automate : exécuter un catamorphisme, c'est faire avancer une machine à pile qui
consomme la structure et maintient un accumulateur de taille bornée — c'est la notation tacite
héritée de la tradition Forth/Factor, où un bloc [dup * +] décrit littéralement l'effet de pile de
son exécution. L'histomorphisme étend cette machine d'un accumulateur d'historique, dont la
profondeur reste bornée par un grade r plutôt que de croître avec l'entrée : c'est la même
machine, à laquelle on adjoint une mémoire supplémentaire elle-même statiquement dimensionnée.
R-expressions et calcul tacite sont ainsi les deux visages d'une même exigence : toute exécution de
couche 3 est un automate dont la mémoire se calcule avant l'exécution, jamais pendant.
Cette exigence détermine à son tour le régime d'exécution qui porte l'automate. Une fibrille est une
coroutine sans pile propre, compilée directement en machine à états : c'est le régime par défaut des
couches 2 et 3, compatible WebAssembly, et c'est lui qui réalise matériellement l'automate borné qui
vient d'être décrit — une fibrille n'est jamais qu'un DFA, un pli ou un flux de plus, portés par le
même mécanisme. Une fibre, à l'inverse, est une coroutine à pile propre, allouée par mmap, seule
capable d'un yield à une profondeur arbitraire. Elle n'est nécessaire que pour les appels FFI
asynchrones vers du code étranger dont la structure d'appel échappe, par construction, à toute borne
statique, et K7PL la confine pour cette raison à la seule couche 1. La distinction n'est donc pas
une préférence d'implémentation : c'est la frontière exacte entre ce qui reste un automate borné et
ce qui doit, pour interagir avec l'extérieur, y renoncer.
Les flux infinis de la couche 2 (@:stream) sont des semicoroutines asymétriques qui prolongent ce
même schéma au cas coinductif. L'anamorphisme du chapitre 2
(§2.3) s'y exécute concrètement comme une machine dont le
compilateur a calculé, à l'avance, la taille maximale de pile, allouée une fois pour toutes dans un
StreamContext fixe. Chaque yield n'est alors qu'un échange de pointeur de contexte en O(1) —
ni allocation, ni copie — de sorte qu'un flux qui ne termine jamais reste, à chaque pas, aussi borné
en mémoire que le pli le plus fini de cette section.
Un mot sur le vocabulaire, car il porte ici une décision et non une commodité. Le régime de la
fibrille couvre les couches 2 et 3, et ces deux couches ne sont pas interchangeables. Elles sont les
deux instances du théorème de progression (chapitre 2,
§2.3), l'une inductive et l'autre coinductive. Leurs
bornes ne viennent pas du même endroit : un indice décroissant porté par le type en couche 3, une
taille de pile précalculée en couche 2. Une taxonomie symétrique voudrait deux mots, fibrille et
cofibrille. Ce document n'en retient qu'un, et pour une raison qui n'est pas l'économie : la
couche détermine déjà la polarité. Dire « une fibrille de couche 2 » dit coinductive, bornée par la
productivité, dotée d'un StreamContext ; un second nom répéterait ce que l'indice porte. Le régime
est donc paramétré par la couche, exactement comme le théorème qui le gouverne, et l'instance
coinductive peut se nommer cofibrille en prose sans que le langage ait à connaître ce mot.
La frontière du vocabulaire coïncide alors avec celle du paramètre, et c'est ce qui justifie de
garder fibre comme un mot distinct plutôt que comme une troisième instance. La couche 1 n'est ni
\mu ni \nu, aucun théorème de progression ne la gouverne, et sa pile n'est pas bornée. Un mot
séparé là où la polarité s'arrête, un seul là où elle s'applique. Le procédé est celui qu'emploient
les langages où la distinction a un contenu : Idris a longtemps porté deux mots-clés pour les
données inductives et coinductives, puis en a retiré un lorsque le type a suffi à dire la polarité.